ロジスティック回帰はなぜ分散処理できる?
重回帰はなぜ分散処理できる? - qz70224の統計学メモ
のロジスティック回帰版です。
根本の考え方は基本的に重回帰と同じなので、詳しくはそちらをご覧ください。
段取りは以下の通りです。
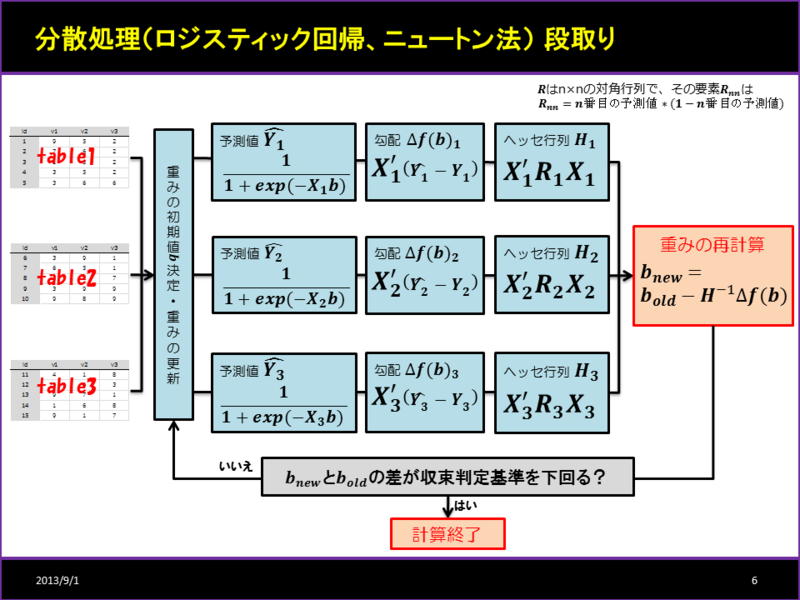
ニュートン法については、以下の資料を参考にさせていただきました。
http://www.chokkan.org/publication/survey/prml_chapter4_discriminative_slides.pdf
以下、プログラムです。
サンプルデータ作成
library(MASS)
mu<-c(0,0,0,0)
Sigma<-matrix(NA,4,4)
diag(Sigma)<-1
Sigma[lower.tri(Sigma)]<-c(0.4,0.3,0.1,0.2,0.3,0.6)
Sigma[upper.tri(Sigma)]<-c(0.4,0.3,0.1,0.2,0.3,0.6)
data<-mvrnorm(n=1000000,mu=mu,Sigma=Sigma,empirical=F)
for(m in 1:nrow(data)){
  if(pnorm(data[m,4])>0.5){
    data[m,4]=1
  }else{
    data[m,4]=0
  }
}
lst<-split(as.data.frame(data),1:10)
計算
#lst=リスト形式のデータ,num=従属変数になる列番号
mpLR<-function(lst,num){

  #デザイン行列を作成する(対象列番号を除外して切片をつける)
  dzmatlst<-split(rep(NA,length(lst)),1:length(lst),1)
  for(k in 1:length(dzmatlst)){
    dzmatlst[[k]] <- as.matrix( cbind(1,lst[[k]][,-num]) )
  }

  #リスト毎に重回帰を実施して初期値決定
  #リスト数×パラメータ数の行列を作成
  wlm<-matrix(NA,ncol(dzmatlst[[1]]),length(lst))
  #リスト毎に重回帰実施し重みを行列に格納
  for(a in 1:length(lst)){
    wlm[,a]<-solve( t(dzmatlst[[a]])%*%dzmatlst[[a]] ) %*% t(dzmatlst[[a]]) %*% lst[[a]][,num]
  }
  #他に特にいい方法が思いつかなかったので、すべての重回帰のパラメータ推定値を平均して初期値にした
  w<-apply(wlm,1,mean)

  #以下よりループ処理
  repeat{

    yhat <- split(rep(NA,length(lst)),1:length(lst),1)
    dfb  <- matrix(NA,ncol(dzmatlst[[1]]),length(lst))
    hess <- array(NA,dim=c(ncol(dzmatlst[[1]]),ncol(dzmatlst[[1]]),length(lst)))

    for(a in 1:length(lst)){
      #リスト毎に予測値定義
      yhat[[a]] <- 1 / ( 1 + exp(-1 * (dzmatlst[[a]] %*% w) ) )

      #リスト毎に勾配
      dfb[,a] <- t(dzmatlst[[a]]) %*% (yhat[[a]]-lst[[a]][,num])

      #リスト毎にヘッセ行列
      R<-yhat[[a]]*(1-yhat[[a]])
      tXR<-matrix(NA,ncol(dzmatlst[[a]]),nrow(dzmatlst[[a]]))
      for(k in 1:nrow(dzmatlst[[a]])){
        tXR[,k]<-dzmatlst[[a]][k,]*R[k]
      }
      hess[,,a]<-tXR%*%dzmatlst[[a]]
    }

    #勾配、ヘッセ行列の和を求める
    dfb<-rowSums(dfb)
    hess<-apply(hess,c(1,2),sum)

    #重みの更新
    w1 <- w-solve(hess)%*%dfb

    #収束判定
    if(max(w1-w)>0.0001){
      w<-w1
    }else{
      break
    }
  }
  se_w<-sqrt(diag(solve(hess)))
  tval<-w/se_w
  for(l in 1:length(lst)){
    if(l==1){
      loglik<-sum( log(yhat[[l]])*lst[[l]][,num] + log(1-yhat[[l]])*(1-lst[[l]][,num]) )
    }else{
      loglik<-loglik + sum( log(yhat[[l]])*lst[[l]][,num] + log(1-yhat[[l]])*(1-lst[[l]][,num]) )
    }
  }
  AIC<--2*(loglik-ncol(dzmatlst[[1]]))

  #出力結果
  out<-list(t(w),se_w,t(tval),-2*loglik,AIC)
  names(out)<-c("w","se_w","tval","-2loglik","AIC")
  return(out)
}
試してみる
start<-proc.time()
res<-mpLR(lst,4)
mpLRtime<-proc.time()-start
> res
$w
             [,1]       [,2]      [,3]     [,4]
[1,] 0.0004474997 -0.4053877 0.5541994 1.335781

$se_w
[1] 0.002353378 0.002715095 0.002707285 0.003178775

$tval
          [,1]      [,2]     [,3]     [,4]
[1,] 0.1901521 -149.3088 204.7067 420.2187

$`-2loglik`
[1] 1073944

$AIC
[1] 1073952

> mpLRtime
   ユーザ   システム       経過
     34.69       0.06      35.12


start<-proc.time()
LR<-glm(data[,4]~data[,1]+data[,2]+data[,3],
        family=binomial(link="logit"))
summary(LR)
LRtime<-proc.time()-start
> summary(LR)

Call:
glm(formula = data[, 4] ~ data[, 1] + data[, 2] + data[, 3],
    family = binomial(link = "logit"))

Deviance Residuals:
    Min       1Q   Median       3Q      Max
-3.1390  -0.8898   0.1131   0.8901   3.0114

Coefficients:
              Estimate Std. Error z value Pr(>|z|)
(Intercept)  0.0004475  0.0023534    0.19    0.849
data[, 1]   -0.4053878  0.0027151 -149.31   <2e-16 ***
data[, 2]    0.5541995  0.0027072  204.71   <2e-16 ***
data[, 3]    1.3357808  0.0031787  420.23   <2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

(Dispersion parameter for binomial family taken to be 1)

    Null deviance: 1386294  on 999999  degrees of freedom
Residual deviance: 1073944  on 999996  degrees of freedom
AIC: 1073952

Number of Fisher Scoring iterations: 4
パラメータ推定値は一致しました。
glm()より処理速度が遅いです。(笑)
あと、一台のマシンですべての処理をしているので、
テーブルを細かく分ければ分けるほど、処理時間は長くなります(笑)
重回帰はなぜ分散処理できる?
大規模データで
重回帰などのいわゆる多変量解析を行う際、
複数のマシンで計算を分担することで処理が早くなるらしい。
分担の際は、各マシンでデータの一部を持っておき、
途中まで計算を行い、最後に足し合わせるらしい。
ただ、なんでそんな事ができるのかが分からなかったので、
調べてみました。
http://machinelearning.wustl.edu/mlpapers/paper_files/NIPS2006_725.pdf
自分の理解が正しければ、考え方は以下の通りです。
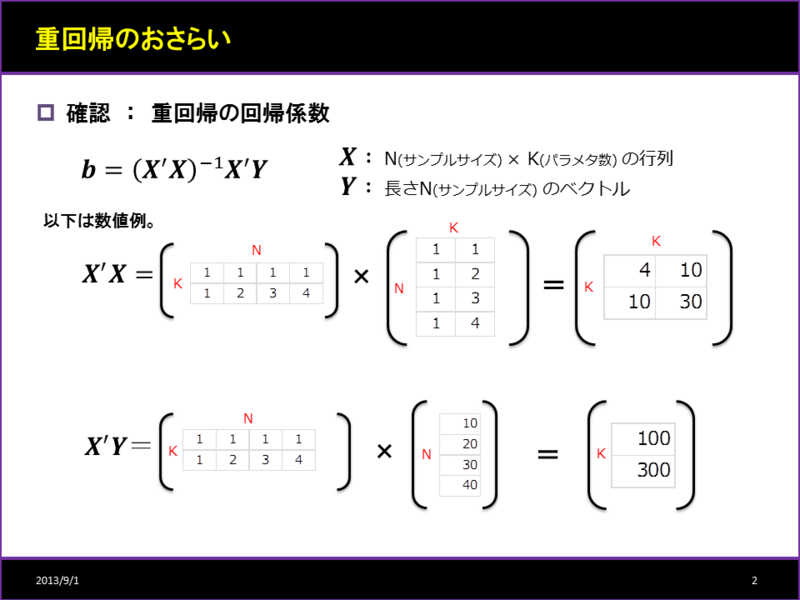
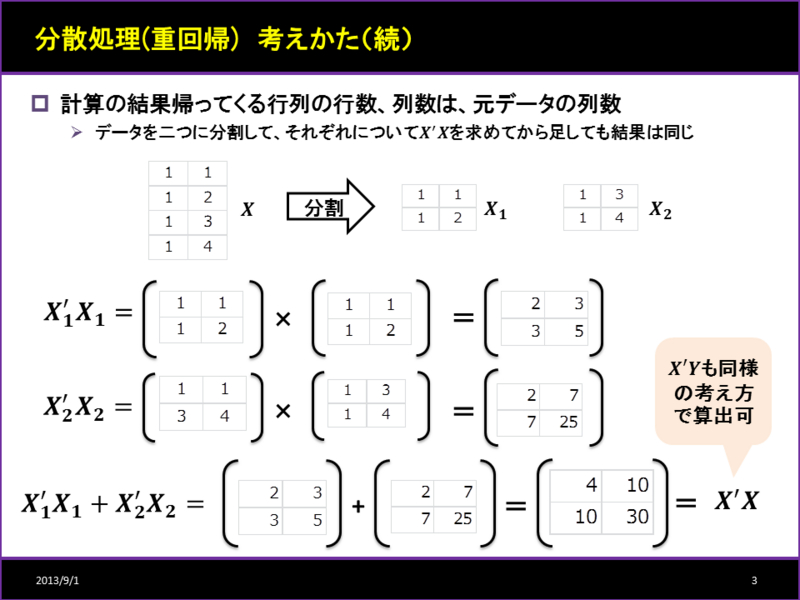
段取りのイメージは以下の通りです。
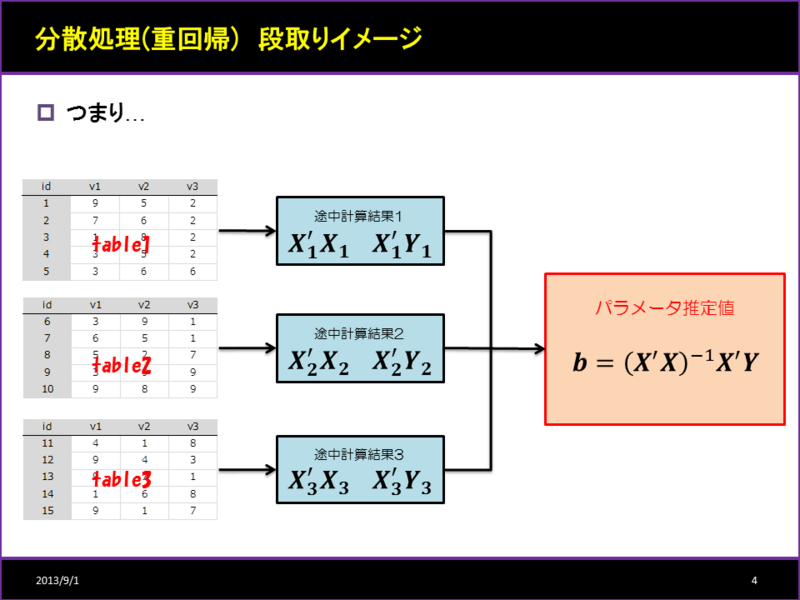
これで一応理屈は分かったのですが、
実際に結果を出してみたくなったので一応プログラムを組んでみました。
自分はシステム周りのことは正直あまりわかっていないので、
一台のマシンでバラバラのテーブルをバラバラのまま計算して、
最後に足し合わせてみました。
つまり、「ひとり分散処理」をやってみました。
まずはサンプルデータの作成
library(MASS)

mu<-c(0,0,0,0)
Sigma<-matrix(NA,4,4)
diag(Sigma)<-1
Sigma[lower.tri(Sigma)]<-c(0.4,0.3,0.1,0.2,0.3,0.6)
Sigma[upper.tri(Sigma)]<-c(0.4,0.3,0.1,0.2,0.3,0.6)
data<-mvrnorm(n=3000000,mu=mu,Sigma=Sigma,empirical=F)
lst<-split(as.data.frame(data),1:3)#データを3つに分割
計算
#lst=リスト形式のデータ,num=従属変数になる列番号
mplm<-function(lst,num){

  #デザイン行列を作成(元データから従属変数を除外して切片をつける)
  dzmatlst<-split(rep(NA,length(lst)),1:length(lst),1)
  for(k in 1:length(dzmatlst)){
    dzmatlst[[k]] <- as.matrix( cbind(1,lst[[k]][,-num]) )
  }

  #XX
  wklst<-dzmatlst
  for(k in 1:length(wklst)){
    wklst[[k]] <- t(wklst[[k]])%*%wklst[[k]]
  }
  xx <- 0
  for(k in 1:length(wklst)){
    xx <- xx + wklst[[k]]
  }
  xx<-solve(xx)

  #XY
  for(k in 1:length(dzmatlst)){
    wklst[[k]] <- t(dzmatlst[[k]])%*%lst[[k]][,num]
  }
  xy <- 0
  for(k in 1:length(wklst)){
    xy <- xy + wklst[[k]]
  }

  #回帰係数
  b<-xx%*%xy

  #予測値
  for(k in 1:length(dzmatlst)){
    if(k==1){
      dzmat<-dzmatlst[[k]]
    }else{
      dzmat<-rbind(dzmat,dzmatlst[[k]])
    }
  }
  yhat<-dzmat%*%b
  yhat<-c(yhat)

  #決定係数
  for(k in 1:length(lst)){
    if(k==1){
      y<-lst[[k]][,num]
    }else{
      y<-c(y,lst[[k]][,num])
    }
  }
  Rsq<-cor(y,yhat)^2
  Rsq<-c(Rsq)

  #残差
  e<-y-yhat

  #回帰係数の標準誤差
  Ssq<- (t(e)%*%e) / (nrow(dzmat)-ncol(dzmat))
  se_b<-sqrt(diag(as.numeric(Ssq)*xx))

  #出力結果
  out<-list(t(b),se_b,Rsq,yhat,e)
  names(out)<-c("b","se_b","Rsq","yhat","e")
  return(out)
}
試してみる
start<-proc.time()
res<-mplm(lst,4)
mptime<-proc.time()-start

> res$b
                1        V1        V2        V3
[1,] 0.0003611049 -0.181937 0.2525769 0.6037954

> res$se_b
           1           V1           V2           V3
0.0004394828 0.0004947975 0.0004817994 0.0004627307

> res$Rsq
[1] 0.4198231

> mptime
   ユーザ   システム       経過
      5.26       0.50       5.83

#lm()と比べてみる
start<-proc.time()
kk<-lm(data[,4]~data[,1]+data[,2]+data[,3])
summary(kk)
time<-proc.time()-start
> summary(kk)

Call:
lm(formula = data[, 4] ~ data[, 1] + data[, 2] + data[, 3])

Residuals:
    Min      1Q  Median      3Q     Max
-3.8623 -0.5132 -0.0006  0.5129  3.9257

Coefficients:
              Estimate Std. Error  t value Pr(>|t|)
(Intercept)  0.0003611  0.0004395    0.822    0.411
data[, 1]   -0.1819370  0.0004948 -367.700   <2e-16 ***
data[, 2]    0.2525769  0.0004818  524.237   <2e-16 ***
data[, 3]    0.6037954  0.0004627 1304.853   <2e-16 ***
---
Signif. codes:  0 ‘***’ 0.001 ‘**’ 0.01 ‘*’ 0.05 ‘.’ 0.1 ‘ ’ 1

Residual standard error: 0.7612 on 2999996 degrees of freedom
Multiple R-squared: 0.4198,	Adjusted R-squared: 0.4198
F-statistic: 7.236e+05 on 3 and 2999996 DF,  p-value: < 2.2e-16

> time
   ユーザ   システム       経過
     17.21       0.74      18.07
パラメータ推定値は一致しました。
lm()より若干処理速度が速いです。
lm()ほど入力方法が親切でないし、最低限の出力しかしないからかな?
と思いました。
あと、一台のマシンですべての処理をしているので、
テーブルを細かく分ければ分けるほど、処理時間は長くなります(笑)
散布図行列
順序カテゴリカルデータの視覚化方法について
スクリプトまで紹介しているすごい便利なホームページがあったので
使ってみた
Correlation scatter-plot matrix for ordered-categorical data | R-statistics blog
scratch-R: scatterplots
ver1:散布図と相関係数
#散布図行列の設定を記憶
panel.cor <- function(x, y, digits=2, prefix="", cex.cor, ...)
{
  usr <- par("usr"); on.exit(par(usr))
  par(usr = c(0, 1, 0, 1))
  r <- round(cor(x, y),digit=2)
  txt <- format(c(r, 0.123456789), digits=digits)[1]
  txt <- paste(prefix, txt, sep="")
  if(missing(cex.cor)) cex <- 0.8/strwidth(txt)
  test <- cor.test(x,y)
  # borrowed from printCoefmat
  Signif <- symnum(test$p.value, corr = FALSE, na = FALSE,
                   cutpoints = c(0, 0.001, 0.01, 0.05, 0.1, 1),
                   symbols = c("***", "**", "*", ".", " "))
  text(0.5, 0.5, txt, cex = cex*r )
  text(.8, .8, Signif, cex=cex*r , col=2)
#  text(0.5, 0.5, txt, cex = 4 )
#  text(.8, .8, Signif, cex=3, col=2)
}

panel.hist <- function(x, ...) # ヒストグラムを描くための関数を定義
{ usr <- par("usr") # 現在のユーザー領域座標情報を得る
  on.exit(par(usr)) # 関数終了時に usr パラメータ復帰
  par(usr = c(usr[1:2], 0, 1.5) ) # ユーザー領域座標情報を変更
  h <- hist(x, breaks=30,plot = FALSE)
  breaks<-h$breaks
  nB <- length(breaks)
  y <- h$counts; y <- y/max(y)
  rect(breaks[-nB], 0, breaks[-1], col = "#0050ff90", border = "#0000ff00", y, ...)
}

panel.lsfit <- function(x,y,...) {
  f <- lsfit(x,y)$coef
  xx<- c ( -99999 , 99999 )
  yy <- f["X"] * xx+ f["Intercept"]
  points(jitter(x),jitter(y), pch = ".", col = "#0000ff50",bg = "#0050ff50")
  lines(xx,yy,col="#00ff0090",lwd=2)
}
以下は使用例
library(psych)
data(bfi)
opar<-par()
par(family="serif")
par(bg="black",fg="white",col.axis="white",col.lab="white",col.main="white",col.sub="white",family="serif")
pairs(na.omit(bfi[1:5]),
      diag.panel=panel.hist,
      lower.panel=panel.cor,
      upper.panel=panel.lsfit)
par(opar)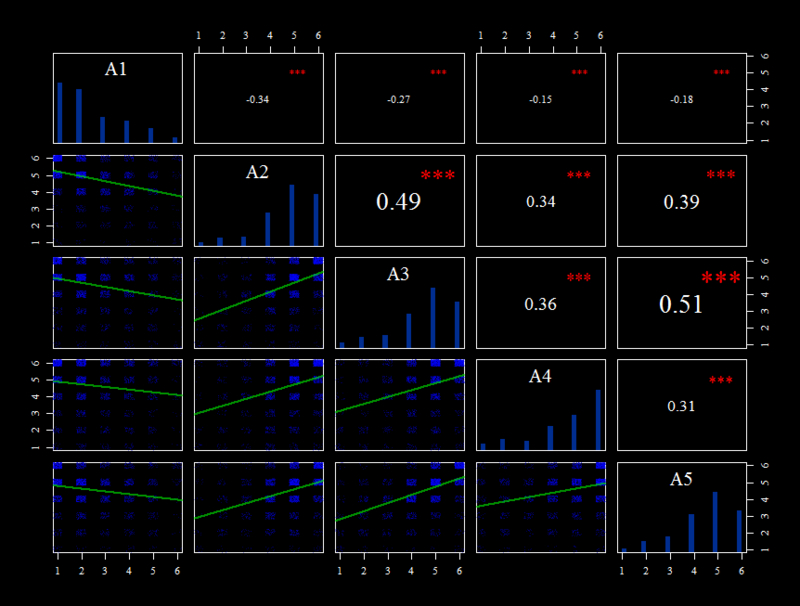
#散布図行列の設定を記憶
#散布図行列の設定を記憶
panel.cor <- function(x, y, digits=2, prefix="", cex.cor, ...)
{

  points(jitter(x),jitter(y), pch = ".", col = "#00ff0050",bg = "#00ff5050")

  r <- round(cor(x, y),digit=2)
  txt <- format(c(r, 0.123456789), digits=digits)[1]
  txt <- paste(prefix, txt, sep="")
  if(missing(cex.cor)) cex <- 0.8
  text( 3,3 , sprintf("cor=%s",txt), cex = cex*3 )
}

panel.hist <- function(x, ...) # ヒストグラムを描くための関数を定義
{ usr <- par("usr") # 現在のユーザー領域座標情報を得る
  on.exit(par(usr)) # 関数終了時に usr パラメータ復帰
  par(usr = c(usr[1:2], 0, 1.5) ) # ユーザー領域座標情報を変更
  h <- hist(x, breaks=30,plot = FALSE)
  breaks<-h$breaks
  nB <- length(breaks)
  y <- h$counts; y <- y/max(y)
  rect(breaks[-nB], 0, breaks[-1], col = "#00ff5090", border = "#00ff0000", y, ...)
}


panel.pcor <- function(x, y, data=na.omit(bfi[1:5]), digits=2, prefix="", cex.cor, ...)
{
  X<-as.matrix(data)
  tmp<-X-x
  tmp<-tmp[,-which(colSums(tmp)==0)]
  tmp<-tmp+x
  tmp<-tmp-y
  tmp<-tmp[,-which(colSums(tmp)==0)]
  tmp<-tmp+y
  X<-tmp
  X<-cbind(1,X)
  fx<-(diag(nrow(data)) - (X %*% solve( t(X) %*% X ) %*% t(X)) ) %*% x
  fy<-(diag(nrow(data)) - (X %*% solve( t(X) %*% X ) %*% t(X)) ) %*% y

  points(fx+3,fy+3, pch = ".", col = "#00ff0050",bg = "#00ff5050")

  r <- round(cor(fx, fy),digit=2)
  txt <- format(c(r, 0.123456789), digits=digits)[1]
  txt <- paste(prefix, txt, sep="")
  if(missing(cex.cor)) cex <- 0.8
  text( 3,3 , sprintf("pcor=%s",txt), cex = cex*3 )
}
以下は使用例
library(psych)
data(bfi)
opar<-par()
par(family="serif")
par(bg="black",fg="white",col.axis="white",col.lab="white",col.main="white",col.sub="white",family="serif")
pairs(na.omit(bfi[1:5]),
      diag.panel=panel.hist,
      lower.panel=panel.cor,
      upper.panel=panel.pcor)
par(opar)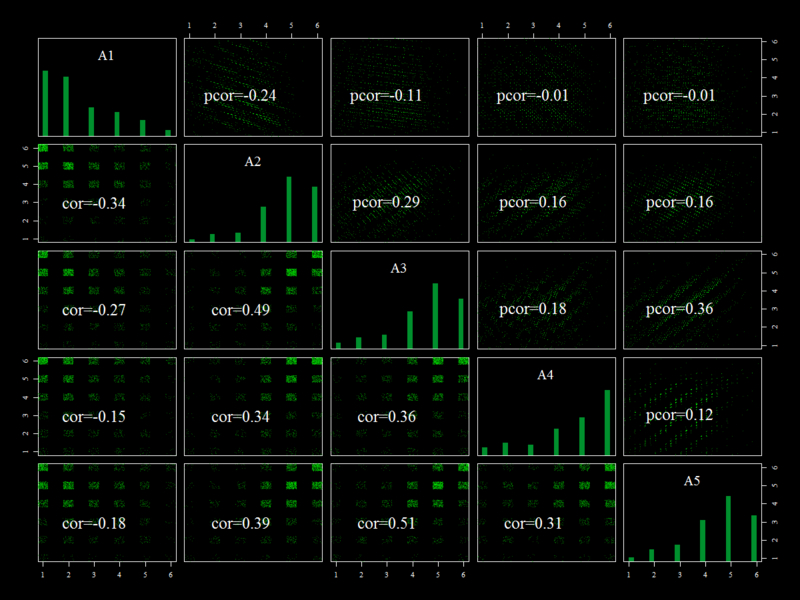
person-year型の架空データ(その2)の結果を使ってお絵かき
w<-t(matrix(b[1:6],2,3))
rho<-b[7]
X<-cbind(1,seq(1, 20, 1),min(birthY))
U<-cbind(X%*%w,0)

ival<-log(exp(U[,1]/rho)+exp(U[,2]/rho))

#クラスター選択確率
CL1<-exp(rho*ival)/(exp(rho*ival)+exp(U[,3]))
CL2<-exp(U[,3])/(exp(rho*ival)+exp(U[,3]))#無職選択確率

#正規、非正規選択確率の計算
P1<-CL1*exp(U[,1]/rho)/(exp(U[,1]/rho)+exp(U[,2]/rho))
P2<-CL1*exp(U[,2]/rho)/(exp(U[,1]/rho)+exp(U[,2]/rho))

hazard<-cbind(P1,P2,CL2)
matplot(hazard,type="s")
surv<-matrix(NA,20,1)
for(k in 1:20){
  surv[k,]<-prod(CL2[1:k])
}

event<-cbind(surv*hazard[,1],surv*hazard[,2])
matplot(event,type="s")

surv<-cbind(matrix(NA,20,2),surv)
for(k in 1:20){
  surv[k,1]<-sum(event[1:k,1])
  surv[k,2]<-sum(event[1:k,2])
}

matplot(surv,type="s")
人名ビンゴ - 抽選回数は何回必要か?
とある飲み会で人名ビンゴをやることになった。
飲み会の人数は12人なので、参加者は12人の中から9人選び、3×3のマスの中に名前を記入していく。
12人のうち2人は人名ビンゴの企画者なので、ビンゴには参加しない。
(つまり参加者は10人)
何回か抽選を行い、その決められた回数以内にビンゴした人には賞品を渡すというルールにすることにした。
当選者が一人も出なかった場合は、企画者が賞品をもらえることにした。
誰もビンゴしないのもつまらないし、みんながビンゴしてもつまらない。
抽選回数は何回にしたらいいだろうか。
シミュレーションの実行
#抽選回数
ncall<-12

#参加人数
nmem<-10

#試行回数
nrep<-1000
simulation<-matrix(0,nrep,ncall)

for(x in 1:nrep){

  #出席者一覧
  name <- 1:12
  n<-length(name)

  #参加人数分のビンゴシートを用意する
  sheet<-array(0,dim=c(3,3,nmem))

  #カウント用
  bingo<-sheet

  #参加者のシート一覧
  for(k in 1:nmem){
    sheet[,,k] <- matrix(sample(name,9),3,3)
  }


  #ビンゴパターンのリストアップ
  #くじ引き
  call<-sample(name,ncall)
  cnt<-matrix(0,nmem,ncall)

  #kは参加者番号
  for(k in 1:nmem){
    #iは呼ばれた出席者の順番
    for( i in 1:ncall ){
      #sheet[,,k]について、シート内に呼ばれた名前があれば、そのセルに1を代入
      row<-which(sheet[,,k]==call[i],arr.ind=TRUE)[1]
      col<-which(sheet[,,k]==call[i],arr.ind=TRUE)[2]
      bingo[row,col,k]<-1

      #ビンゴ数のカウント
      if(sum(bingo[,1,k])==3){cnt[k,i]=cnt[k,i]+1}
      if(sum(bingo[,2,k])==3){cnt[k,i]=cnt[k,i]+1}
      if(sum(bingo[,3,k])==3){cnt[k,i]=cnt[k,i]+1}
      if(sum(bingo[1,,k])==3){cnt[k,i]=cnt[k,i]+1}
      if(sum(bingo[2,,k])==3){cnt[k,i]=cnt[k,i]+1}
      if(sum(bingo[3,,k])==3){cnt[k,i]=cnt[k,i]+1}
      if(bingo[1,1,k]+bingo[2,2,k]+bingo[3,3,k]==3){cnt[k,i]=cnt[k,i]+1}
      if(bingo[1,3,k]+bingo[2,2,k]+bingo[3,1,k]==3){cnt[k,i]=cnt[k,i]+1}
    }}


  flag<-matrix(0,nmem,ncall)

  for(a in 1:nmem){
    for(b in 1:ncall){
      if(cnt[a,b]!=0){flag[a,b]=1}
    }
  }

  for(c in 1:nmem){
    if(c==1){FLG=flag[c,]}
    else{FLG=FLG+flag[c,]}
  }

  simulation[x,]<-FLG
}

X<-NA
for(d in 1:nrep){
  if(d==1){X=simulation[d,]}
  else{X=X+simulation[d,]}
}
X<-X/nrep
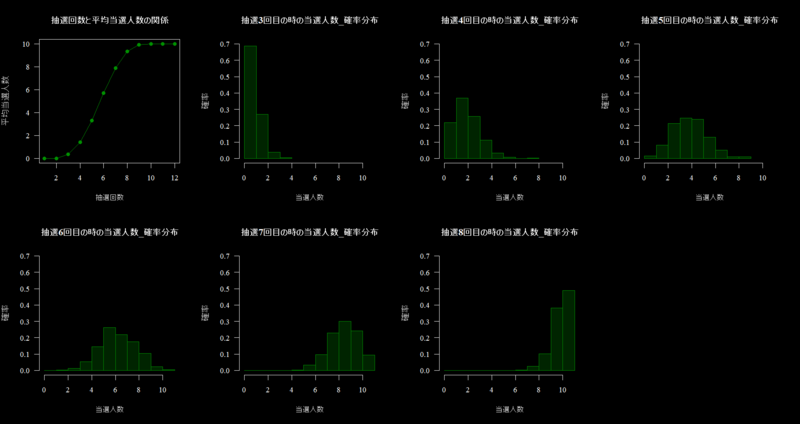
結果を可視化
opar<-par()
par(mfrow=c(2,4),family="serif",cex=1.2,
    bg="black",fg="white",
    col.axis="white",col.lab="white",col.main="white",col.sub="white")

plot(X,
     main="抽選回数と平均当選人数の関係",
     xlab="抽選回数",
     ylab="平均当選人数",
     las=1,
     type="o",
     col="#009000ff",
     pch=19
)

for(k in 3:8){
  hist(simulation[,k],breaks=0:(max(simulation[,k])+1),
     freq=F,
     right=F,
     main=sprintf("抽選%0d回目の時の当選人数_確率分布",k),
     ylab="確率",
     xlab="当選人数",
     ylim=c(0,0.70),
     xlim=c(0,11),
     col="#00900040",
     border="#009000",
     las=1
       )
}
Diff.sim<-simulation[,2:12]-simulation[,1:11]
Diff.sim<-cbind(0,Diff.sim)


Y<-NA
for(d in 1:nrep){
  if(d==1){Y=Diff.sim[d,]}
  else{Y=Y+Diff.sim[d,]}
}
Y<-Y/nrep

par(opar)
par(mfrow=c(2,4),family="serif",cex=1.2,
    bg="black",fg="white",
    col.axis="white",col.lab="white",col.main="white",col.sub="white")

plot(Y,
     main="抽選回数と平均当選人数の関係",
     xlab="抽選回数",
     ylab="当該抽選回数での平均当選人数",
     las=1,
     type="o",
     col="#500090ff",
     pch=19
)

for(k in 3:9){
  hist(Diff.sim[,k],breaks=0:(max(Diff.sim[,k])+1),
       freq=F,
       right=F,
       main=sprintf("抽選%0d回目の時点で当選する人数_確率分布",k),
       ylab="確率",
       xlab="当選人数",
       ylim=c(0,0.70),
       xlim=c(0,11),
       col="#50009040",
       border="#500090",
       las=1
  )
}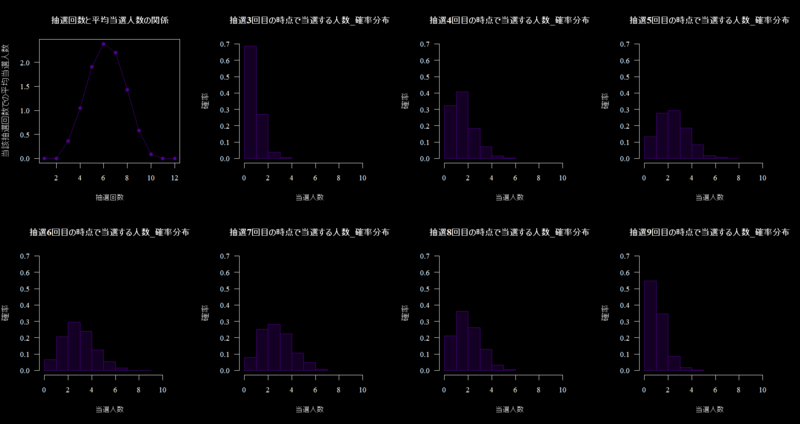
…抽選回数は4回にすることにした。
person-year型の架空データ(その2)
person-year型の架空データ(その1)をベースに、
仮定するデータ発生メカニズムを変更
就業選択に階層構造を仮定する
①就業するか否か
②就業するとしたら、正規雇用か、非正規雇用か
*単純化のために、ここでは就業形態を正規、非正規の2つにしている
その他の条件はperson-year型の架空データ(その1)と同じ
→以上のような状況を、離散時間入れ子型ロジットモデルで表現する
モデル定義
NestedLogitModel<-function(x,time,birthY){

  b1_1<-x[1]#切片
  b1_2<-x[2]#切片
  b2_1<-x[3]#リスク継続時間
  b2_2<-x[4]#リスク継続時間
  b3_1<-x[5]#出生コーホート
  b3_2<-x[6]#出生コーホート
  rho<-x[7]

  #効用の計算
  U1<-b1_1+b2_1*time[,1]+b3_1*birthY[,1]
  U2<-b1_2+b2_2*time[,1]+b3_2*birthY[,1]
  U3<-0

  #クラスター1のログサム変数
  #「正規」「非正規」の間に相関を仮定
  ival<-log(exp(U1/rho)+exp(U2/rho))

  #クラスター選択確率
  CL1<-exp(rho*ival)/(exp(rho*ival)+exp(U3))
  CL2<-exp(U3)/(exp(rho*ival)+exp(U3))#無職選択確率

  #正規、非正規選択確率の計算
  P1<-CL1*exp(U1/rho)/(exp(U1/rho)+exp(U2/rho))
  P2<-CL1*exp(U2/rho)/(exp(U1/rho)+exp(U2/rho))

  Pr<-cbind(P1,P2,CL2)
  return(Pr)
}
モデルからデータを発生させる
#①独立変数とパラメータを定義する

#乱数のseedを設定
set.seed(999)

#パラメタの設定
#正規
beta1_1<--3.5
beta1_2<--0.03
beta1_3<-0.022
#非正規
beta2_1<--4
beta2_2<-0.035
beta2_3<-0.02
#rho
rho<-0.2

betas<-c(beta1_1,beta2_1,beta1_2,beta2_2,beta1_3,beta2_3,rho)

n<-1000 #サンプルサイズ
t<-25 #観測年数
py<-n*t

ID<-matrix(0,py,2) #個人ID,リスク継続年数
Y<-matrix(0,py,3) #就業状態
birthY<-matrix(0,py,1) #出生年

for(i in 1:n){
  WKbirthY<-floor(rnorm(n=1,mean=65,sd=10))
  for(j in 1:t){
    r<-(i-1)*t+j #1からn*tまでのカウント変数として解釈
    ID[r,1]<-i #IDのr行1列目にiを代入せよ
    ID[r,2]<-j #IDのr行2列目にjを代入せよ

    #出生年の定義
    birthY[r,1]<-WKbirthY
  }
}
time<-matrix(0,py,1)
time[,1]<-ID[,2]


#②NestedLogitModelを用いて選択確率を発生させる
PPr<-NestedLogitModel(betas,time,birthY)


#③発生させた選択確率をもとに各時点の就業状態を定義する
for(i in 1:py){
  CSPPr<-cumsum(PPr[i,]) #i行目のケースの累積確率ベクトル
  rn<-runif(1)
  PPM<-which.max(CSPPr>=rn)
  Y[i,PPM]<-1 #i行PPM列目のYに1を代入
}

data<-cbind(ID,birthY,Y)

#再就業発生以降のデータは消去
for(i in 2:py){
  if(data[i,1]==data[i-1,1] && data[i-1,4]==1) data[i,4]<-9
  if(data[i,1]==data[i-1,1] && data[i-1,4]==9) data[i,4]<-9
  if(data[i,1]==data[i-1,1] && data[i-1,5]==1) data[i,5]<-9
  if(data[i,1]==data[i-1,1] && data[i-1,5]==9) data[i,5]<-9
}
data<-as.data.frame(data)
data<-subset(data,data$V4!=9)
data<-subset(data,data$V5!=9)

data<-as.matrix(data)
colnames(data)<-c("ID","time","birthY","seiki","hiseiki","mushoku")
発生させたデータからパラメータ推定値を得る
#ベクトルとして認識しなおす
ID=data[,c("ID")]
time=data[,c("time")]
birthY=data[,c("birthY")]
Y=data[,c("seiki","hiseiki","mushoku")]


#NestedLogitModelの推定
#尤度関数の定義
frnes<-function(x,Y,time,birthY){

  b1_1<-x[1]#切片
  b1_2<-x[2]#切片
  b2_1<-x[3]#リスク継続時間
  b2_2<-x[4]#リスク継続時間
  b3_1<-x[5]#出生年
  b3_2<-x[6]#出生年
  rho<-x[7]

  #効用の計算
  U1<-b1_1+b2_1*time+b3_1*birthY
  U2<-b1_2+b2_2*time+b3_2*birthY
  U3<-0

  #クラスター1のログサム変数
  #「正規」「非正規」の間に相関を仮定
  ival<-log(exp(U1/rho)+exp(U2/rho))

  #クラスター選択確率
  CL1<-exp(rho*ival)/(exp(rho*ival)+exp(U3))
  CL2<-exp(U3)/(exp(rho*ival)+exp(U3))#無職選択確率

  #正規、非正規選択確率の計算
  P1<-CL1*exp(U1/rho)/(exp(U1/rho)+exp(U2/rho))
  P2<-CL1*exp(U2/rho)/(exp(U1/rho)+exp(U2/rho))

  #これらより、尤度関数は
  likelihood<-Y[,1]*P1+Y[,2]*P2+Y[,3]*CL2
  L<-prod(likelihood) #尤度関数

  #対数尤度関数は
  loglik<-Y[,1]*log(P1)+Y[,2]*log(P2)+Y[,3]*log(CL2)
  LL<-sum(loglik) #対数尤度関数

  return(LL)
}

b0<-c(0,0,0,0,0,0,0.15)#パラメータの初期値

#frを最大化する
res<-optim(b0,frnes,gr=NULL,Y,time,birthY,method="BFGS",
           hessian=T,control=list(fnscale=-1))
#パラメータ推定値
b<-res$par
#t値と情報量基準
tval<-b/sqrt(-diag(solve(res$hessian)))
AIC<--2*res$value+2*length(res$par) #-2*対数尤度+2*自由度
BIC<--2*res$value+log(nrow(Y))*length(res$par) #-2*対数尤度+log(サンプルサイズ)*自由度

以下は実行結果。
> b
[1] -3.27779339 -3.68524722 -0.02670424  0.03344167  0.01846105  0.01539592  0.19054824
> tval
[1] -13.290818 -12.071085  -2.088800   2.899009   4.970577   4.074132   2.731473
> AIC
[1] 6814.842
> BIC
[1] 6864.681
多項ロジットモデルで推定すると
#MNLmodelの推定。
#尤度関数の定義
fr<-function(x,Y,time,birthY){

  b1_1<-x[1]#切片
  b1_2<-x[2]#切片
  b2_1<-x[3]#リスク継続時間
  b2_2<-x[4]#リスク継続時間
  b3_1<-x[5]#出生年
  b3_2<-x[6]#出生年

  #効用の計算
  U1<-b1_1+b2_1*time+b3_1*birthY
  U2<-b1_2+b2_2*time+b3_2*birthY
  U3<-0

  #選択確率の分母を定義
  d<-exp(U1)+exp(U2)+exp(U3)

  #選択確率の計算
  P1<-exp(U1)/d
  P2<-exp(U2)/d
  P3<-exp(U3)/d

  #これらより、尤度関数は
  likelihood<-Y[,1]*P1+Y[,2]*P2+Y[,3]*P3
  L<-prod(likelihood) #尤度関数

  #よって、対数尤度関数は
  loglik<-log(Y[,1]*P1+Y[,2]*P2+Y[,3]*P3)
  LL<-sum(loglik) #対数尤度関数

  return(LL)
}

b0<-c(0,0,0,0,0,0)#パラメータの初期値

#frを最大化する
res<-optim(b0,fr,gr=NULL,Y,time,birthY,method="BFGS",
           hessian=T,control=list(fnscale=-1))
#パラメータ推定値
b<-res$par
#t値と情報量基準
tval<-b/sqrt(-diag(solve(res$hessian)))
AIC<--2*res$value+2*length(res$par) #-2*対数尤度+2*自由度
BIC<--2*res$value+log(nrow(Y))*length(res$par) #-2*対数尤度+log(サンプルサイズ)*自由度

結果
> b
[1] -3.382198060 -4.969953179 -0.116013794  0.120316407  0.023009270  0.008775567
> tval
[1] -11.164212 -12.533858 -11.328430  15.260224   5.128217   1.491521
> AIC
[1] 6855.353
> BIC
[1] 6898.073→入れ子型ロジットモデルのほうがあてはまりがよい
person-year型の架空データ(その1)
パーソン・イヤー型の架空データをRを使用し作成
架空データなので、
とりあえずざっくりと以下のような状況を仮定してみる
再就業の分析
・正規雇用からの離職を20-29歳の間に経験した女性が分析対象
・分析対象となるイベントは「再就業」
・就業状態は「正規」「非正規」「自営業」「無職」の四つ
・分析対象の定義より、リスク開始は「正規雇用からの離職」
・「無職」から何らかの就業形態に移行することでイベント発生とし、観察終了
・25年以上移行が発生していないケースは打ち切り
・共変量は出生年、リスク継続年数(線形関係を仮定)
→以上のような状況を、離散時間多項ロジットモデルで表現する
モデル定義
MNLmodel<-function(x,time,birthY){

b1_1<-x[1]#切片
b1_2<-x[2]#切片
b1_3<-x[3]#切片
b2_1<-x[4]#リスク継続年数
b2_2<-x[5]#リスク継続年数
b2_3<-x[6]#リスク継続年数
b3_1<-x[7]#出生年
b3_2<-x[8]#出生年
b3_3<-x[9]#出生年

#効用の計算
U1<-b1_1+b2_1*time[,1]+b3_1*birthY[,1]
U2<-b1_2+b2_2*time[,1]+b3_2*birthY[,1]
U3<-b1_3+b2_3*time[,1]+b3_3*birthY[,1]
U4<-0

#選択確率の分母を定義
d<-exp(U1)+exp(U2)+exp(U3)+exp(U4)

#選択確率の計算
P1<-exp(U1)/d
P2<-exp(U2)/d
P3<-exp(U3)/d
P4<-exp(U4)/d
Pr<-cbind(P1,P2,P3,P4)
return(Pr) #PrをMNLmodelの出力として返せ
}
モデルからデータを発生させる
#①独立変数とパラメータを定義する

#乱数の結果を保存
set.seed(999)

#パラメタの設定
#正規
beta1_1<--3.8
beta1_2<--0.02
beta1_3<-0.008
#非正規
beta2_1<--4
beta2_2<-0.03
beta2_3<-0.02
#自営業
beta3_1<--4.5
beta3_2<-0.001
beta3_3<-0.002

betas<-c(beta1_1,beta2_1,beta3_1,beta1_2,beta2_2,beta3_2,beta1_3,beta2_3,beta3_3)

n<-1000 #サンプルサイズ
t<-25 #観測年数
py<-n*t

ID<-matrix(0,py,2) #個人ID,リスク継続年数
Y<-matrix(0,py,4) #就業状態
birthY<-matrix(0,py,1) #出生年

for(i in 1:n){
  WKbirthY<-floor(rnorm(n=1,mean=65,sd=10))
  for(j in 1:t){
       r<-(i-1)*t+j #1からn*tまでのカウント変数として解釈
       ID[r,1]<-i #IDのr行1列目にiを代入せよ
       ID[r,2]<-j #IDのr行2列目にjを代入せよ

#出生年の定義
       birthY[r,1]<-WKbirthY
}
}
time<-matrix(0,py,1)
time[,1]<-ID[,2]


#②MNLmodelを用いて選択確率を発生させる
PPr<-MNLmodel(betas,time,birthY)


#③発生させた選択確率をもとに各時点の就業状態を定義する
for(i in 1:py){
CSPPr<-cumsum(PPr[i,]) #i行目のケースの累積確率ベクトル
rn<-runif(1)
PPM<-which.max(CSPPr>=rn)
Y[i,PPM]<-1 #i行PPM列目のYに1を代入
}
data<-cbind(ID,birthY,Y)

#④再就業発生以降のデータは消去する
for(i in 2:py){
  if(data[i,1]==data[i-1,1] && data[i-1,4]==1) data[i,4]<-9
  if(data[i,1]==data[i-1,1] && data[i-1,4]==9) data[i,4]<-9
  if(data[i,1]==data[i-1,1] && data[i-1,5]==1) data[i,5]<-9
  if(data[i,1]==data[i-1,1] && data[i-1,5]==9) data[i,5]<-9
  if(data[i,1]==data[i-1,1] && data[i-1,6]==1) data[i,6]<-9
  if(data[i,1]==data[i-1,1] && data[i-1,6]==9) data[i,6]<-9
}
data<-as.data.frame(data)
data<-subset(data,data$V4!=9)
data<-subset(data,data$V5!=9)
data<-subset(data,data$V6!=9)

data<-as.matrix(data)
colnames(data)<-c("ID","time","birthY","seiki","hiseiki","ziei","mushoku")
発生させたデータからパラメータ推定値を得る
#ベクトルとして認識しなおす
ID=data[,c("ID")]
time=data[,c("time")]
birthY=data[,c("birthY")]
Y=data[,c("seiki","hiseiki","ziei","mushoku")]

#MNLmodelの推定。
#尤度関数の定義
fr<-function(x,Y,time,birthY){

  b1_1<-x[1]#切片
  b1_2<-x[2]#切片
  b1_3<-x[3]#切片
  b2_1<-x[4]#リスク継続時間
  b2_2<-x[5]#リスク継続時間
  b2_3<-x[6]#リスク継続時間
  b3_1<-x[7]#出生年
  b3_2<-x[8]#出生年
  b3_3<-x[9]#出生年

  #効用の計算
  U1<-b1_1+b2_1*time+b3_1*birthY
  U2<-b1_2+b2_2*time+b3_2*birthY
  U3<-b1_3+b2_3*time+b3_3*birthY
  U4<-0

  #選択確率の分母を定義
  d<-exp(U1)+exp(U2)+exp(U3)+exp(U4)

  #選択確率の計算
  P1<-exp(U1)/d
  P2<-exp(U2)/d
  P3<-exp(U3)/d
  P4<-exp(U4)/d

  #これらより、尤度関数は
  likelihood<-Y[,1]*P1+Y[,2]*P2+Y[,3]*P3+Y[,4]*P4
  L<-prod(likelihood) #尤度関数

  #よって、対数尤度関数は
  loglik<-log(Y[,1]*P1+Y[,2]*P2+Y[,3]*P3+Y[,4]*P4)
  LL<-sum(loglik) #対数尤度関数

  return(LL)
}

b0<-c(0,0,0,0,0,0,0,0,0)#パラメータの初期値

#frを最大化する
res<-optim(b0,fr,gr=NULL,Y,time,birthY,method="BFGS",
             hessian=T,control=list(fnscale=-1))
#パラメータ推定値
b<-res$par
#t値と情報量基準
tval<-b/sqrt(-diag(solve(res$hessian)))
AIC<--2*res$value+2*length(res$par) #-2*対数尤度+2*自由度
BIC<--2*res$value+log(nrow(Y))*length(res$par) #-2*対数尤度+log(サンプルサイズ)*自由度
